垂直大模型技术创新的“专业燃料”:为什么知识产权高质量数据集不可或缺?
2026/04/16 15:24AI云资讯15940
当前,国家高度重视以人工智能引领科研范式变革,将高质量数据集建设作为人工智能发展的核心底座,加快建设人工智能语料库、面向重点领域打造高质量数据集,为AI产业高质量发展筑牢数据根基。
随着大模型、垂直领域智能体快速落地,专业领域可信语料供给成为行业刚需,知识产权数据凭借权威来源、高知识密度、合规可追溯等天然优势,成为训练专业大模型的优质“燃料”,知识产权高质量数据集建设,正成为激活AI创新效能、支撑科技自立自强的重要支撑。
通用大模型也需要高质量数据,但“高质量”的定义不同
通用大模型的训练数据强调广度、多样性和基础干净度。它们需要海量的网页、书籍、论文、代码等语料,经过过滤去重、去除明显错误与偏见后即可使用。这类数据中,知识产权数据只是锦上添花的一部分,并非必不可少。但在专业垂直场景中——例如专利审查、技术研发决策、侵权判定、知识产权交易,通用模型的“知识匮乏”与“推理偏差”问题就会被无限放大。这是因为:
缺乏领域术语与结构化知识:通用语料不会系统性地包含“权利要求”“同族专利”“法律状态”等专业概念及其逻辑关系。
缺乏权威且合规的来源:互联网上的技术信息真假混杂、版权模糊,无法用于严肃的商业或法律场景。
缺乏专家级标注:模型不知道一个专利属于哪个技术分类,不知道其法律状态变化,也无法准确判断创新价值。
对垂直大模型技术创新而言,通识数据难以满足专业场景需求,知识产权数据集可有效提升模型在技术分析、专利检索、侵权判定、技术转化等场景的专业性与准确性,解决垂直领域“知识匮乏”“推理偏差”等痛点。
因此,垂直领域模型要真正可用,必须使用领域专属的高质量数据集。而在科技、法律、创新管理等核心场景中,知识产权数据——尤其是专利、商标、版权等,正是最权威、最结构化、最合规的高质量语料。它不是“加分项”,而是“及格线”。
为什么必须是知识产权数据?
在众多专业数据中,知识产权数据天然具备成为AI顶级训练语料的四大独特属性:
1.来源权威合规,全链路可追溯。数据源自各国专利局、官方知识产权机构等权威渠道,授权清晰、确权完整,符合数据分类分级与安全管理要求,从采集到应用全流程合规可控,规避版权与法律风险。
2.知识密度高,加工标准化。经过专业清洗、去重、标引、结构化处理,剔除冗余信息,保留技术方案、权利要求、法律状态等核心知识;建立统一数据标准与专业词典,保障数据一致性与规范性。
3.多语种全覆盖,跨域可对齐。覆盖中、英、日、韩、法、德、俄等主流语种,具备跨语言平行对齐能力,支持单语种检索全球知识产权信息,适配全球化研发与创新场景。
4.专家级标注,场景适配性强。由知识产权与技术专家参与标注,覆盖技术领域划分、法律条款关联、创新价值判定等维度,数据可直接用于模型微调与任务推理,大幅降低训练成本。
知识产权数据能带来什么:全生命周期的构建
用专利等知识产权数据构建的高质量数据集,能为垂直大模型技术创新带来三大核心价值:
1.专业能力的跃升。模型可以准确理解技术方案、判断新颖性与创造性、识别侵权风险、辅助专利撰写与审查。这些能力是通用模型无法具备的。
2.安全与合规的保障。由于数据来源明确、授权清晰,企业可以放心地将模型部署在高合规要求的业务中,如专利审查、技术转化、知识产权交易、出口管制合规等。
3.研发与创新效率的提升。高质量知识产权数据集支撑的AI模型,能帮助科研人员、企业IP部门、技术转移机构快速检索全球技术信息、分析技术趋势、识别空白领域,缩短研发周期,加速创新成果转化。
知识产权高质量数据集的打造,是覆盖采集、清洗、标注、确权、应用的全链条系统工程,也是行业落地的关键。
全域采集:搭建全球知识产权数据采集网络,同步多国专利、商标等数据,保障数据广度与实时性,形成规模化基础资源池。
专业加工:建立多语种平行语料库,通过同族专利处理、跨语言对齐等技术,实现数据标准化与互通性;依托专家标注体系,形成适配不同场景的细分数据集。
合规确权:与国家级平台协同,明确数据来源与使用权限,建立严格安全管控机制,保障数据应用安全可控。
场景赋能:数据集可直接支撑研发创新、专利审查、技术转化、侵权分析等场景,帮助创新主体提升效率、规避风险、加速成果转化。
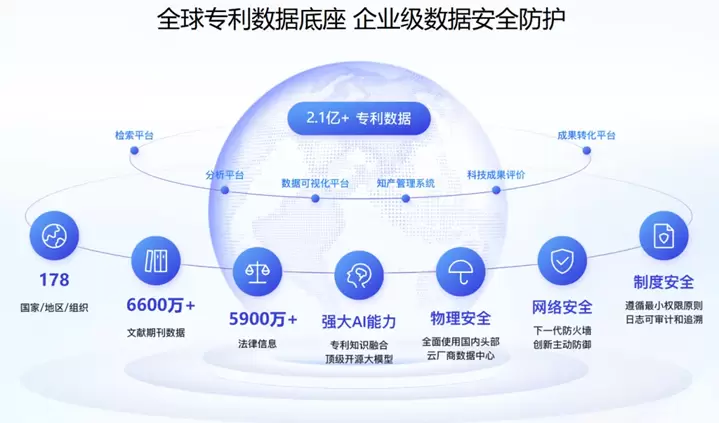
作为深耕知识产权数据领域的科技企业,八月瓜科技历经十年沉淀,构建了覆盖知识产权语料全生命周期的技术体系与服务能力。目前,公司已建成全球178个国家和地区的专利数据库,覆盖超2亿条专利数据及26亿条多维科技数据,这是国内覆盖最广、更新最快的知识产权数据资源体系之一。依托多语种平行语料库、专家级标注体系与合规确权机制,打造能源、智能制造、生物医药、航空航天等数百个领域的知识产权高质量数据集,可全面满足垂直大模型技术创新的多元需求。
目前,八月瓜科技高质量数据集已支撑“擎策”系列产品服务超万家机构,以可信、专业、高效的知识产权数据服务,为人工智能与科技创新深度融合持续赋能。(AI云资讯 易云 报道)
相关文章
- 大模型爆发第三年,语音输入进入第三代:意图成稿
- 小巧机身驱动本地千亿级大模型:联想AI主机P7预览版亮相,同步启动“先享计划”
- 从“算力”到“Token 生产力”,硅基流动助力央国企大模型规模化落地
- 大模型时代如何革新影像 相芯科技给出一体化AI工作流方案
- 云从科技签约武汉国家网安基地大模型训推一体化项目
- 蓝沃AI在工博会首次展示订单履约工作台,同步开源沃土大模型2.0
- 江波龙面向端侧AI,以AIDIMM™赋能AIPC大模型部署
- 预装35B模型、支持超千亿大模型本地运行:联想YOGA Pro 15 RTX Spark超级AIPC今晚8点开售
- 镕铭微电子与贝壳科技签署战略合作协议 软硬协同,共建视频垂类大模型与AIGC创作平台
- 从大模型导调到反无集群实飞:天枢Studio反无对抗体系验证全链路解析
- 微星发布紧凑型AI智能体主机EdgeMesa N AI+:本地最大运行200B大模型!
- 智者大模型3.0在杭发布 全国首个成果转化大模型再升级
- 千问上架鸿蒙电脑,搭载Qwen大模型!手机实况窗、服务卡片同步升级
- 高通CEO安蒙:2028年前手机或可运行千亿参数大模型
- 赛意信息入选IDC中国工业AI及智能体图谱,覆盖工业大模型、AI平台等11大细分市场
- 安世亚太“精智iGPT”工业大模型通过国家网信办备案