Imec与格芯宣布在AI芯片领域取得突破,将深度神经网络计算用于物联网边缘设备
2020/07/15 12:21AI云资讯11867
全球领先的纳米电子和数字技术研究及创新中心Imec联合先进的特殊工艺半导体晶圆代工厂格芯®(GLOBALFOUNDRIES®),于近日宣布一款新型人工智能芯片。这款新型芯片基于采用格芯22FDX®解决方案的Imec模拟内存内计算(AiMC)架构,经过优化可在模拟域的内存计算硬件上执行深度神经网络计算。该加速器可以实现高达2,900TOPS/W的创纪录能效,是低功耗设备边缘推理的关键要素。这项新技术在隐私、安全和延迟方面的优势将会对各种边缘设备的人工智能应用产生影响,包括从智能扬声器至自动驾驶汽车等应用。
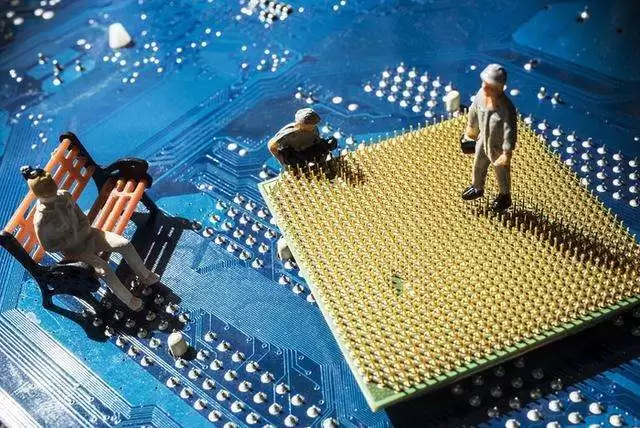
自早期的数字计算时代以来,处理器就已经与存储器分离开来。使用大量数据进行的运算同样需要大量从存储器检索的数据元素。这种限制(称为冯诺依曼瓶颈)可能会掩盖实际的计算时间,尤其是在依赖于大型向量矩阵乘法运算的神经网络中。这些计算利用精密的数字计算机进行,并且需要消耗大量的能量。但是,如果使用精度较低的模拟技术进行向量矩阵乘法运算,神经网络也能获得准确的结果。
为应对这个挑战,Imec及其工业联盟机器学习计划的行业合作伙伴(包括格芯)开发了一个新架构。该架构通过在SRAM单元中进行模拟计算,消除了冯诺依曼瓶颈问题。由此而来的模拟推理加速器(AnIA)构建于格芯22FDX半导体平台上,能效表现出色。表征测试表明,能效最高可达2,900 TOPS/W。如今可以在这款高能效加速器上本地执行微型传感器和低功率边缘设备中的模式识别(通常由数据中心的机器学习提供支持)。
Imec机器学习计划总监DiederikVerkest表示:“AnIA的成功试产标志着模拟内存内计算(AiMC)的验证又向前迈出了重要一步。此次参考实现不仅表明模拟内存内计算是切实可行的,而且还可实现数字加速器10至100倍的能效。在Imec的机器学习计划中,我们对现有的以及新兴的内存设备进行优化调整,使它们适合模拟内存内计算。这些令人满意的结果鼓舞着我们进一步开发这项技术,朝着10,000 TOPS/W的目标迈进。”
格芯计算和有线基础架构产品管理副总裁Hiren Majmudar表示:“格芯一直与Imec保持着密切合作伙伴关系,以便利用我们的低功耗、高性能22FDX平台实现新型AnIA芯片。此款测试芯片是向业界展示22FDX如何显著降低能耗密集型人工智能和机器学习应用功耗的关键一步。”
展望未来,格芯将在22FDX平台上实现AiMC功能,以便在AI市场领域提供差异化解决方案。格芯的22FDX采用22nm FD-SOI技术,在极低功耗下提供出色的性能,并能够以0.5 V超低电压和1皮安/微米(pA/um)的电流工作,实现超低待机泄漏。具有全新AiMC功能的22FDX正在格芯位于德国德累斯顿Fab 1的先进300mm生产线上进行开发。
相关文章
- 全球首款RISC-V数据流物理AI芯片高光D35正式量产 数贸会首发首秀引关注
- 安谋科技荣获“边缘AI芯片领军企业奖”,全场景AI技术获行业认可
- 台积电高管重磅宣布:CoWoS封装AI芯片良率确认达98%
- 六岳微亮相2026苏州智博会,工控AI芯片迎来“场景定义”新玩家
- WAIC 2026 | 科华数据算力基础设施与AI芯片协同发展论坛圆满落幕!
- 科华数据与多家主流AI芯片厂商携手亮相2026WAIC,全面展示人工智能时代的科华实力!
- Anthropic将采用三星2纳米芯片制造工艺技术代工AI芯片
- 苹果向博通投入300亿美元,用于自研AI芯片Baltra ASIC及无线和射频组件
- 韩国AI芯片企业FuriosaAI下一代AI加速器采用2nm芯粒架构,支持HBM4/E内存
- AI芯片散热告急!三安光电解锁先进封装“降温密码“
- AI芯片竞争战火升级,特斯拉/Meta/微美全息自研硬核实力发起行业冲锋革命!
- OpenAI新模型发布,Meta/微美全息以AI芯片+模型布局加速行业创新进程
- 中昊芯英“刹那®”TPU AI芯片Day0适配智谱GLM-5
- OpenAI首次采用Cerebras的AI芯片运行Codex模型,成功实现了每秒1000次事务处理量
- 英伟达已瞄准台积电1.6nm产能,特斯拉/微美全息加速扩展AI芯片集群生态!
- 微软正式发布第二代自研AI芯片Maia 200