让大模型少做重复计算 中科曙光发布ParaCache
2026/08/28 17:14AI云资讯16949
8月28日,2026中国国际大数据产业博览会期间,中科曙光发布新一代词元加速方案ParaCache。该方案通过保存并复用大模型已经完成的计算结果,减少不同请求、不同计算节点之间的重复计算。测试显示,在约12万词元输入下,ParaCache可使模型开始回答前的等待时间最高降低98.5%;高并发场景下,系统每秒处理的词元量最高达到原来的27倍。
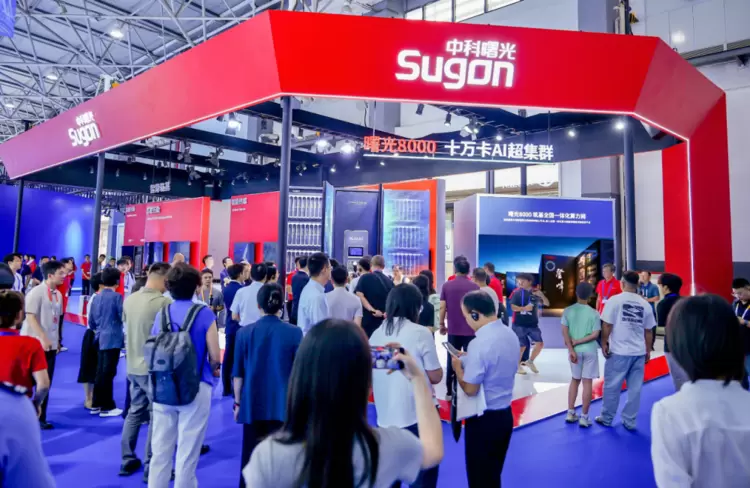
少做重复计算,让算过的直接复用
随着大模型进入长文本、多轮对话、知识库问答和智能体等场景,大量相同或相似内容被反复计算,不仅增加等待时间,也持续消耗算力资源。
ParaCache的思路很直接:把已经算过的结果长时间保存下来,下次需要时直接复用。
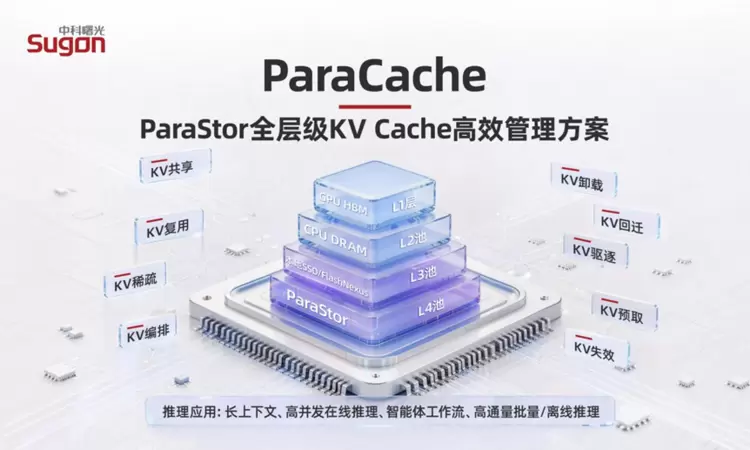
该方案统一管理GPU显存、CPU内存、固态硬盘和分布式存储,根据使用频率对计算结果进行分层存放和智能调度,并支持在不同请求、不同计算节点之间共享,实现“一次计算、多次使用”。
ParaCache以曙光分布式存储ParaStor为基础,并融合集中式全闪存储FlashNexus,将存储能力从保存原始数据进一步延伸至保存和复用大模型计算结果,在减少重复计算的同时,降低对高成本显存的占用。
“多快好省”,推理效率全面提升
ParaCache带来的价值,可以概括为“多、快、好、省”。
“多”:高并发场景下,系统每秒处理的词元量最高达到原来的27倍,同样的硬件资源能够承接更多业务请求。
“快”:输入约12万词元时,单轮对话开始回答前的等待时间可降至0.4秒;连续20轮对话中,这一时间由43.1秒降至4.9秒。
“好”:兼容主流推理框架和国产AI加速卡,可在现有系统基础上接入,降低部署和迁移成本。
“省”:高频内容保留在显存,其他内容转移至成本更低的存储设备,减少对高成本显存和新增硬件资源的依赖。
目前,ParaCache已在国内某头部互联网企业在线推理业务中落地,模型开始回答前的平均等待时间降低50%以上;在同等硬件条件下,系统可承载的业务请求也提升数倍。
同时,ParaCache已在全国产十万卡AI超集群曙光8000上完成验证,可面向长文本对话、知识库问答、智能客服、智能体及高并发推理等场景。
中科曙光北京公司总裁助理、分布式存储产品部总经理石静表示,ParaCache不是简单提升单张GPU的性能,而是通过减少重复计算,把更多算力用于处理新的任务。
过去,存储主要负责保存数据。ParaCache进一步将模型已经完成的计算结果纳入存储和复用体系。对于大模型推理而言,少一次重复计算,就意味着少一段等待,也少一份算力消耗。
围绕本届数博会“词元——数据要素价值释放新路径”主题,ParaCache提供了一条更具体的技术路径:不仅保存数据,也保存数据在计算过程中产生的结果,让一次计算形成的价值被持续复用。
相关文章
- 中科曙光出席数据存储产业大会,以实践回应AI新需求
- 大捷智能携手中科曙光打造工业AI设计超级云平台——AI设计应用进入快车道!
- 从建好到用好,中科曙光聚焦Token生产效率
- 中科曙光在CCF HPC2026展示AI4S新进展
- 全栈算力成果亮相!中科曙光参展HPC China 2026
- 首词元时延最高降低98.5%!中科曙光ParaCache助力词元加速
- 让大模型少做重复计算 中科曙光发布ParaCache
- 中科曙光AI存储连续三年市场第一
- 从超节点到AI超集群:中科曙光的算力“组合拳”
- 中科曙光全链路解决方案亮相2026科学智能大会
- 直击AI4S算力难题!中科曙光全链路解决方案亮相2026科学智能大会
- 第七届“先导杯”决赛揭榜,中科曙光打造智能计算
- 中科曙光董事长历军:让中国的计算技术站在世界中央
- 中科曙光与豫信电科战略签约,共促河南智能产业升级
- 中科曙光落成首个全国产十万卡AI超集群
- 中科曙光亮相欧洲,展示前沿AI基础设施“中国方案”
AI企业
更多>>
AI硬件
更多>>- 化繁为简 智领机先 解码心系天下三星W27背后的高阶AI生产力
- 从尺寸平衡到体验升维 解读三星Galaxy Z Fold8的沉浸式折叠创新哲学
- 拯救者×《影之刃零》联名定制款笔记本正在预售中,11月11日正式开售
- Partyhouse派对屋音响丨25平米客厅影K一体音响前装落地,颜值与全景声双向统一
- 从「最佳AI拍摄眼镜」到「最佳AI眼镜创新奖」 BleeqUp 连获两项行业大奖
- 黑鲨2026秋季发布会六款新品齐发:从散热到全品类,战力全开
- 端侧跑通超千亿参数大模型!联想YOGA Pro 15 RTX Spark开启盲约,重塑个人生产力边界
- 销售额超25亿!QCY凭什么从东莞代工小厂成长为全球耳机TOP4?